Monitoring / logs / traces / observabilité
Contactez-moi- Prometheus
- Grafana
- OpenTelemetry
- Kibana
- Elasticsearch
- Caddy
Le monitoring classique vérifie qu’un système est “up” ou “down”. L’observabilité va plus loin : elle vise à comprendre pourquoi un système se comporte d’une certaine façon, en croisant trois types de signaux - les métriques (chiffres agrégés dans le temps), les logs (événements détaillés) et les traces (parcours d’une requête à travers plusieurs services). C’est indispensable dès qu’une application est découpée en plusieurs services communicants.
Historique
Le monitoring d’infrastructure classique remonte à des outils comme Nagios (1999), centrés sur des checks de disponibilité. Prometheus, créé en 2012 chez SoundCloud, introduit un modèle de métriques par “pull” et un langage de requête dédié (PromQL), rapidement associé à Grafana (2014) pour la visualisation. Le terme “observabilité” se popularise avec la montée des microservices, et OpenTelemetry (2019, fusion des projets OpenTracing et OpenCensus) émerge comme standard commun pour instrumenter métriques, logs et traces sans dépendre d’un fournisseur propriétaire.
Avantages des versions récentes
- OpenTelemetry comme standard unifié : une seule instrumentation pour envoyer les données vers l’outil de son choix (Prometheus, Elastic, Grafana Tempo…), sans verrouillage fournisseur.
- Traçage distribué généralisé : suivre une requête de bout en bout à travers plusieurs microservices pour localiser précisément un ralentissement ou une erreur.
- Instrumentation par eBPF : observabilité “zéro code” au niveau noyau, sans modifier l’application pour obtenir des métriques réseau et système fines.
- Détection d’anomalies assistée par IA : les outils modernes identifient des comportements inhabituels dans les métriques/logs avant qu’ils ne deviennent des incidents visibles.
Tableau de bord Kibana sur les logs Caddy
Le serveur web Caddy qui sert mes sites écrit un journal d’accès pour chaque requête : site demandé, code de statut, durée, adresse IP source, navigateur. Ces logs sont indexés dans Elasticsearch et exploités dans un tableau de bord Kibana qui donne, d’un coup d’œil, l’état du trafic sur les dernières 24 heures.
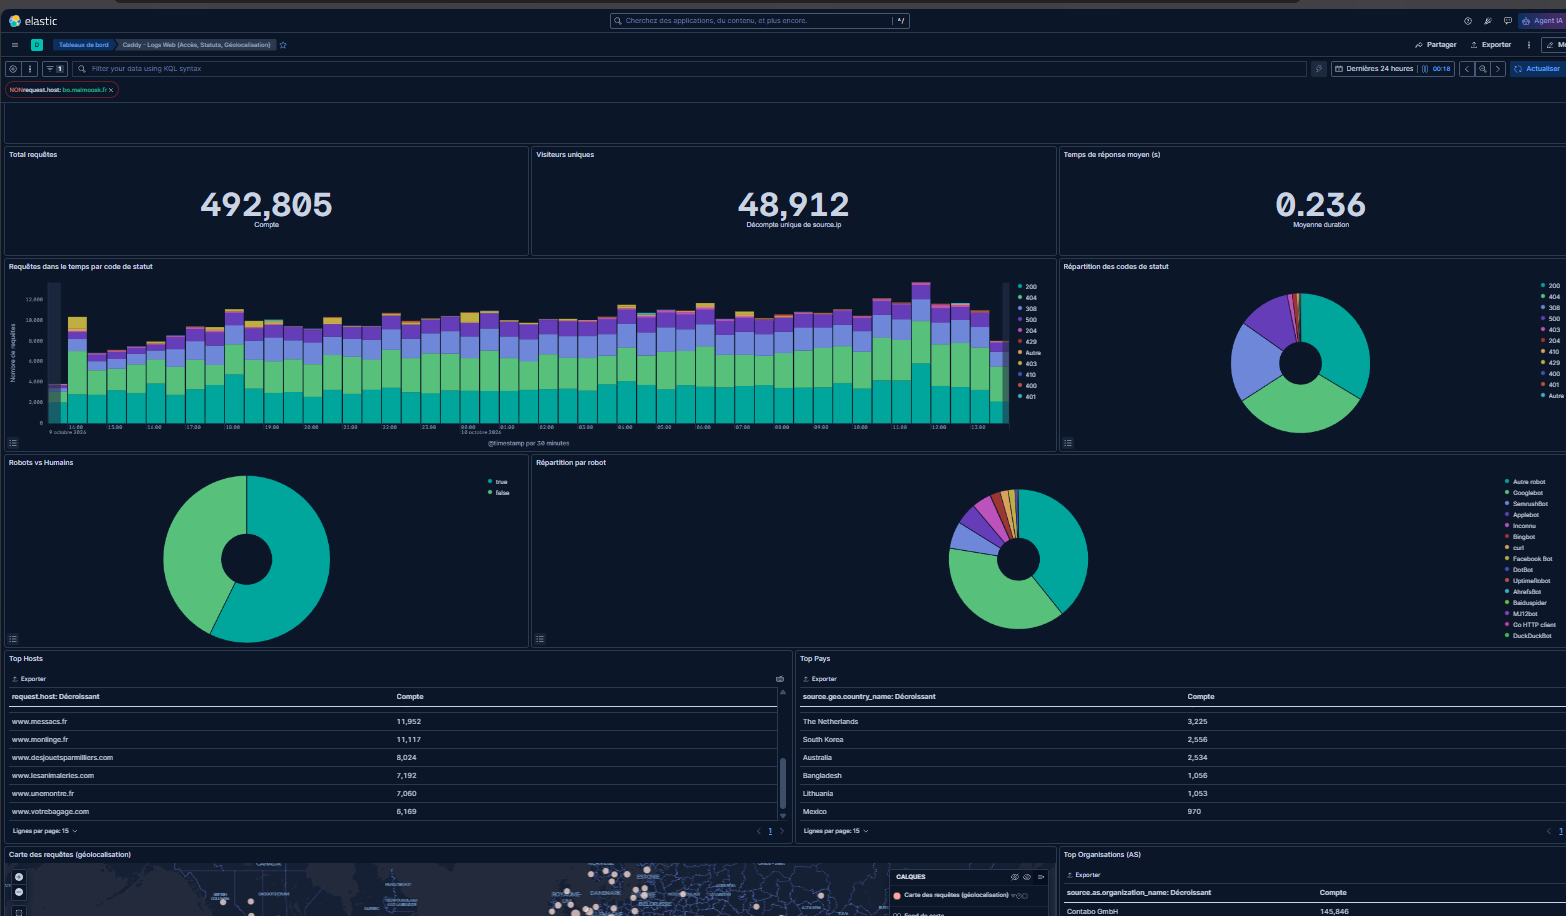
Ce que montre le tableau de bord :
- Trois indicateurs clés : le nombre total de requêtes (environ 493 000 sur la période), les visiteurs uniques comptés par adresse IP source (environ 48 900) et le temps de réponse moyen (0,236 s).
- Requêtes dans le temps par code de statut : un histogramme par tranches de 30 minutes, empilé par code (200, 404, 308, 500, 429…). Un pic de 5xx signale une panne, un pic de 404 un scan, un pic de 429 une limitation de débit qui se déclenche.
- Répartition des codes de statut : la proportion de succès, de redirections et d’erreurs.
- Robots contre humains et répartition par robot : quelle part du trafic vient de robots, et lesquels (Googlebot, Bingbot, Applebot, outils SEO comme SemrushBot et AhrefsBot, clients
curlou Go). C’est la base pour décider quels robots autoriser, limiter ou bannir. - Top des sites : les domaines les plus sollicités du serveur, pour repérer le site qui consomme les ressources.
- Top pays, carte de géolocalisation et top organisations (AS) : l’origine géographique et réseau du trafic. Un hébergeur qui génère à lui seul une part énorme des requêtes est généralement un robot ou un scanner, et alimente les décisions de bannissement par pays ou par plage d’adresses.
Un filtre en haut du tableau de bord (par exemple exclure un hôte) et la période sélectionnée s’appliquent à tous les panneaux en même temps : on passe d’une vue globale à l’analyse d’un site ou d’un incident en quelques clics.
Mon expertise
J’assure la supervision de mes serveurs et de mes sites, en m’appuyant notamment sur les journaux du serveur web :
- un tableau de bord Kibana sur les logs Caddy (requêtes, visiteurs uniques, temps de réponse, codes de statut dans le temps) ;
- l’analyse du trafic : part des robots, sites les plus sollicités, pays et organisations réseau à l’origine des requêtes, carte de géolocalisation ;
- l’usage de ces indicateurs pour repérer les pannes, les scans et les robots abusifs, et décider des bannissements.